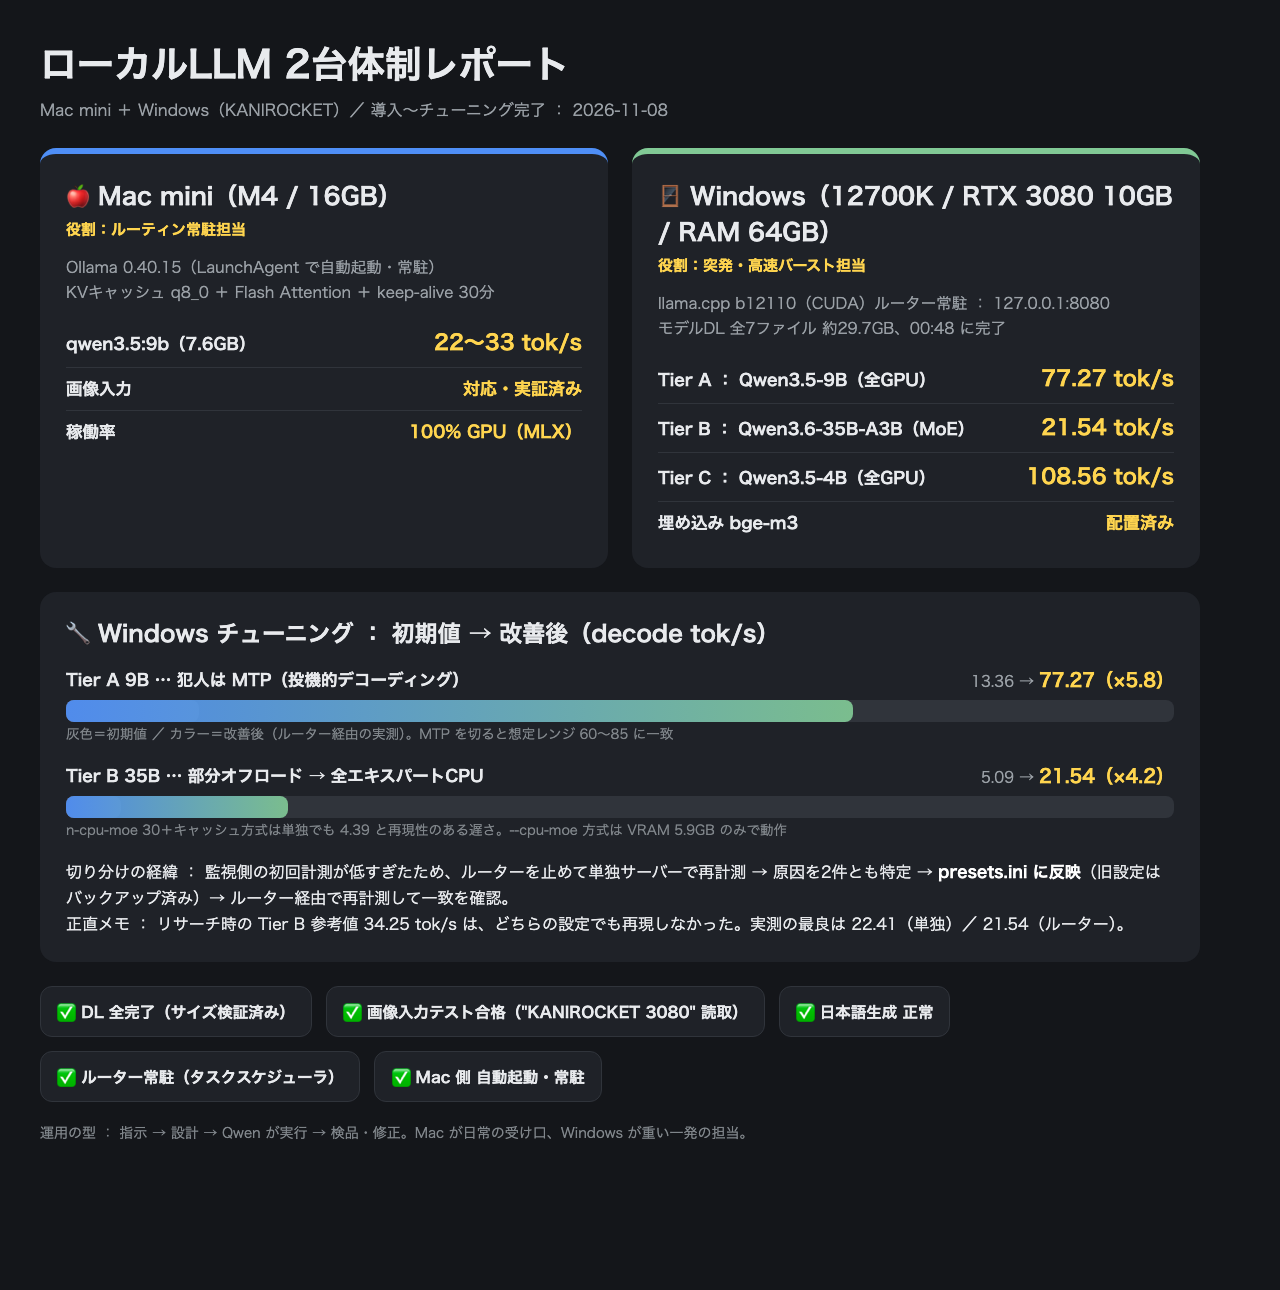
推論速度(最終実測)
77.27 tok/s ― Qwen3.5-9B(Tier A)
35B は 21.54 tok/s、4B は 108.56 tok/s。短い出力なら両機とも体感は互角。
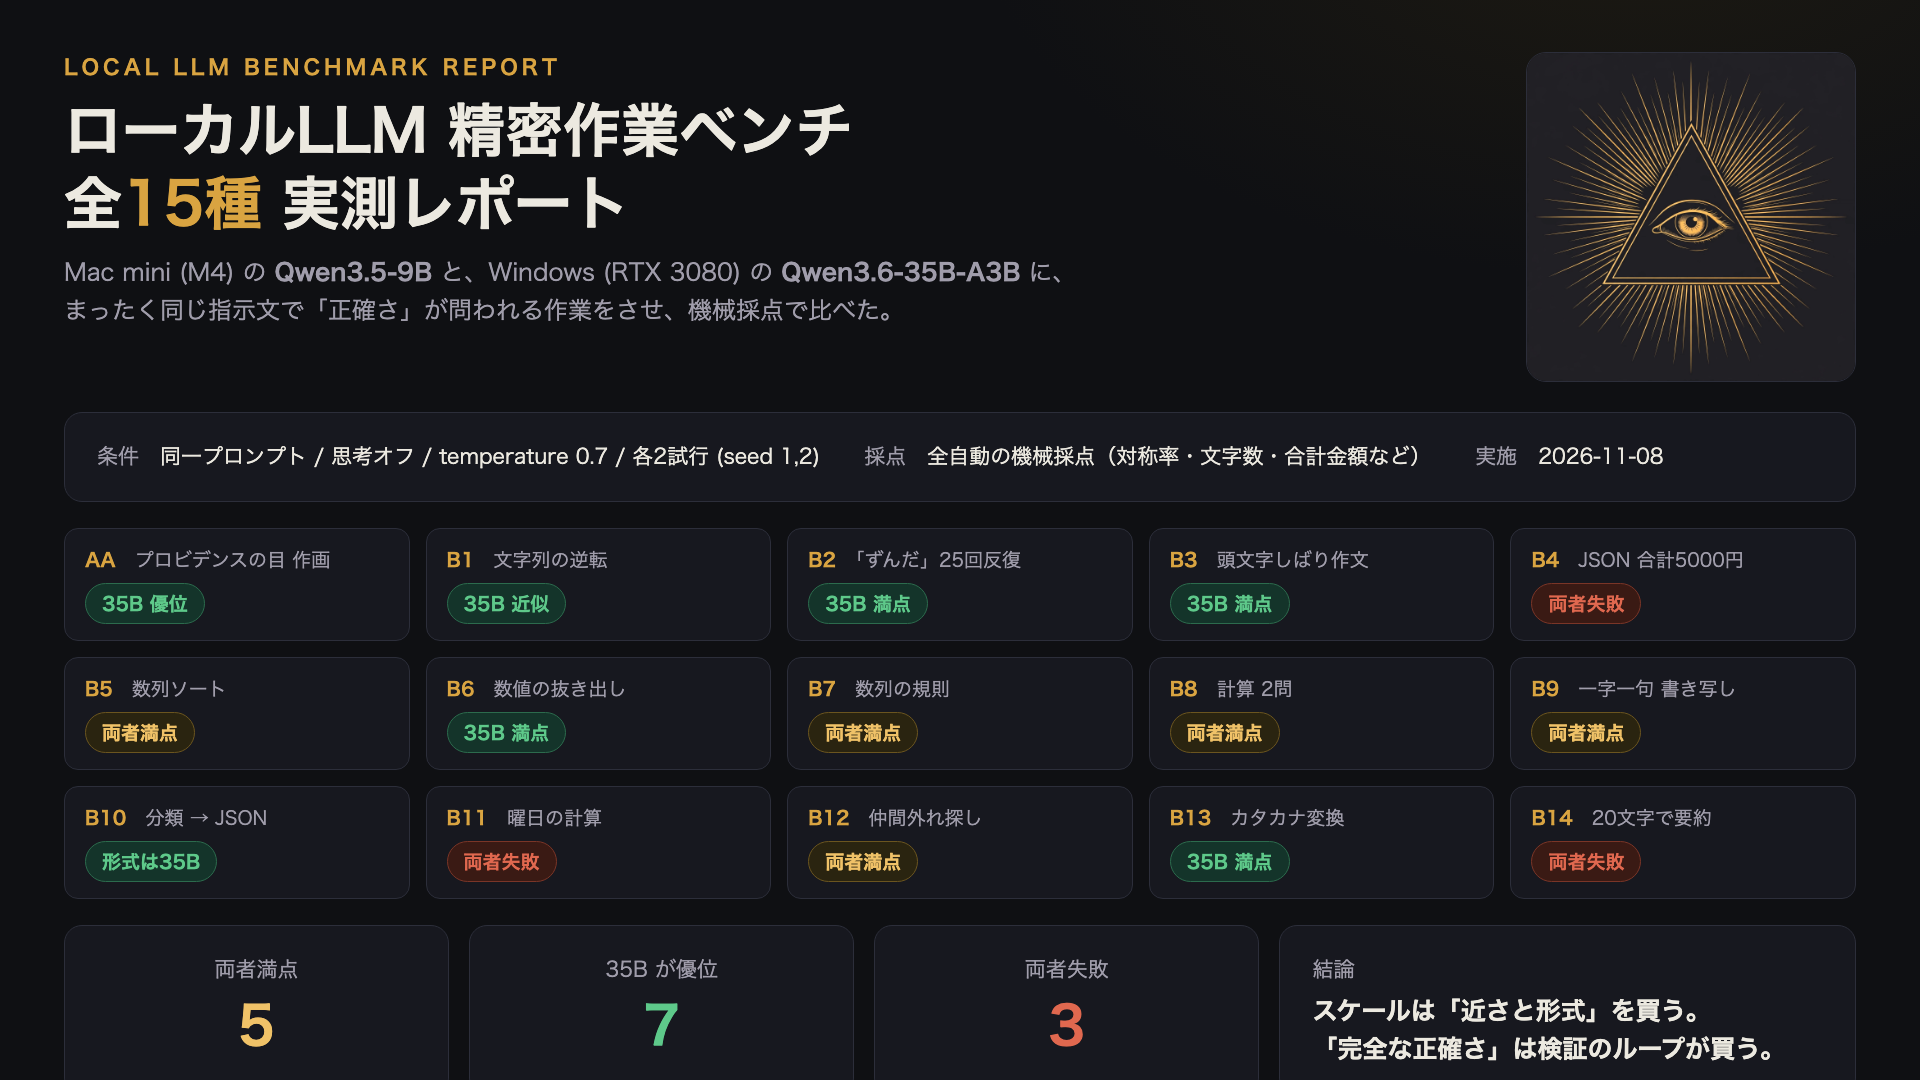
精密作業ベンチ 15種
両者満点 5種/35B 優位 7種/両者の壁 3種(検算・日数積算・文字数管理)。
→ 「精密15種」タブ
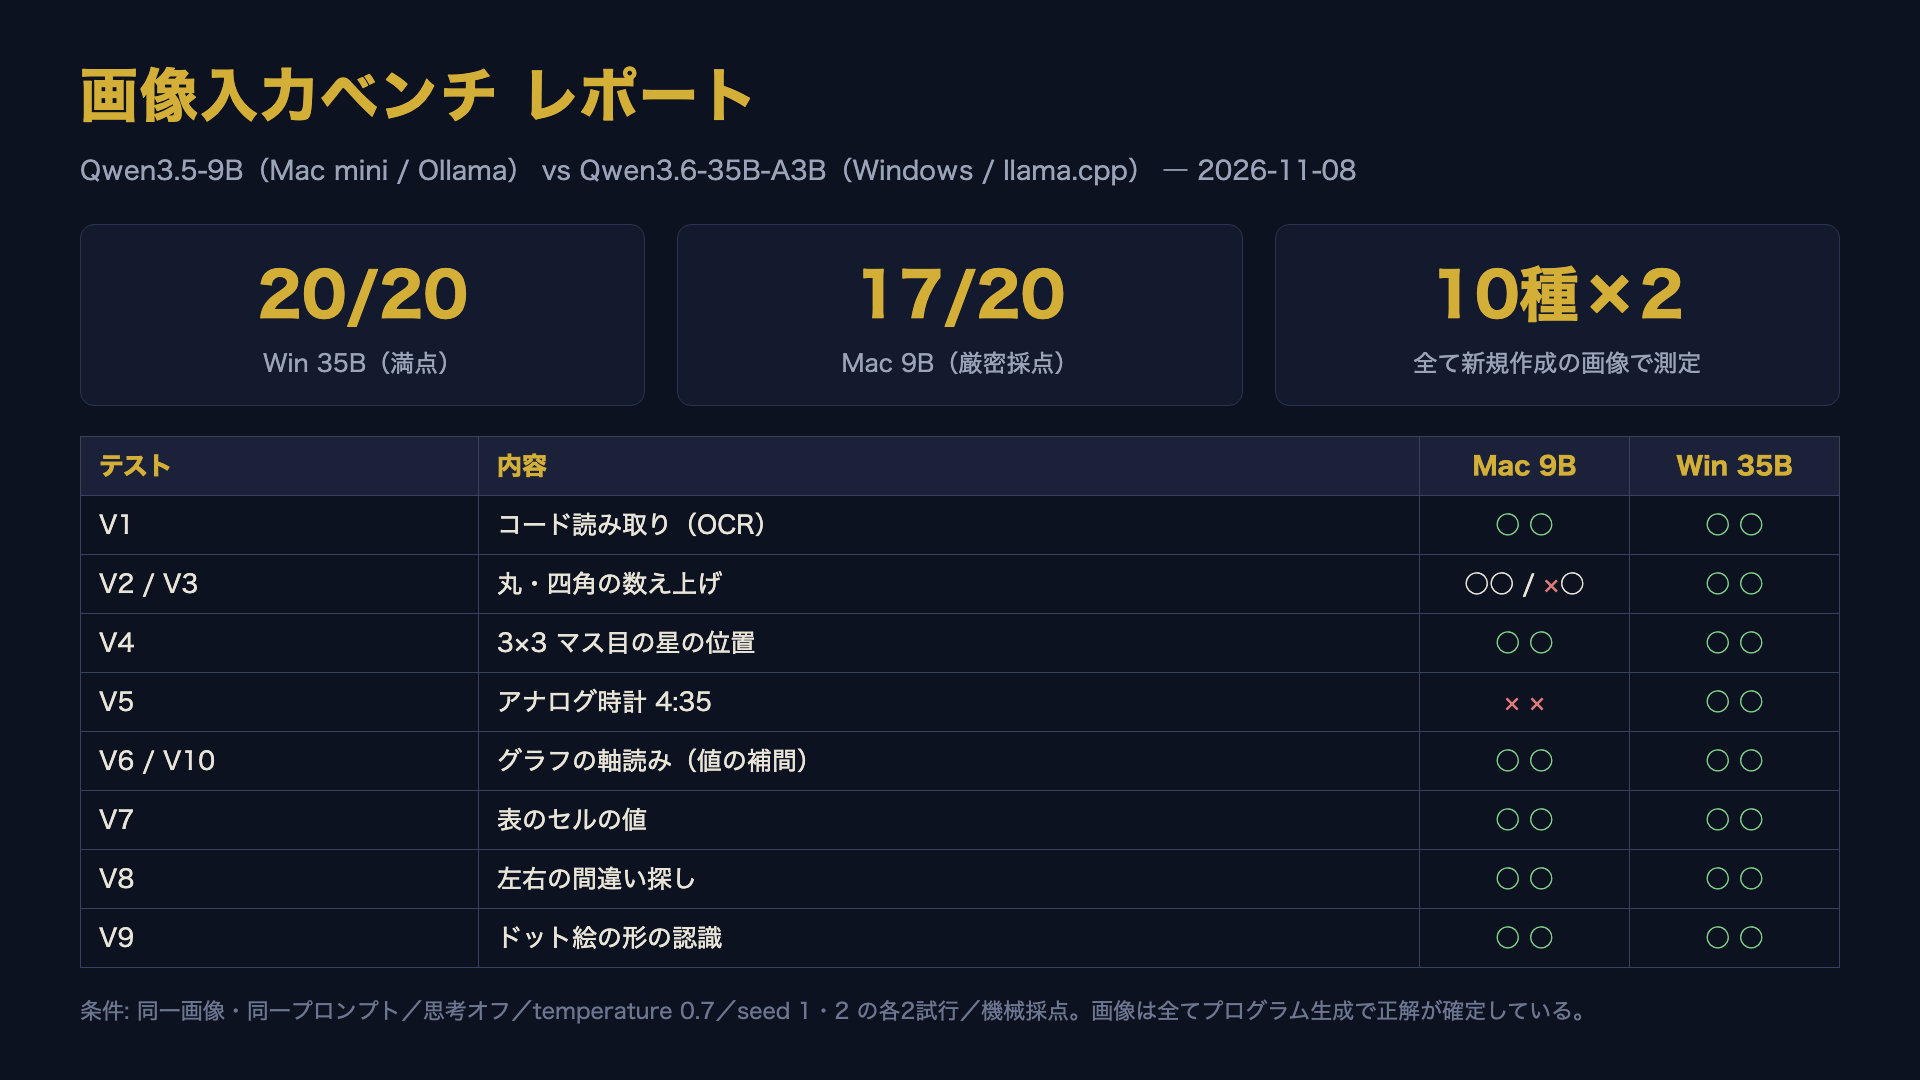
画像入力ベンチ V1〜V10
Mac 17 ― Win 20
作り物画像では 35B が満点。軸読みの補間まで両機ほぼ完璧。
→ 「画像ベンチ」タブ
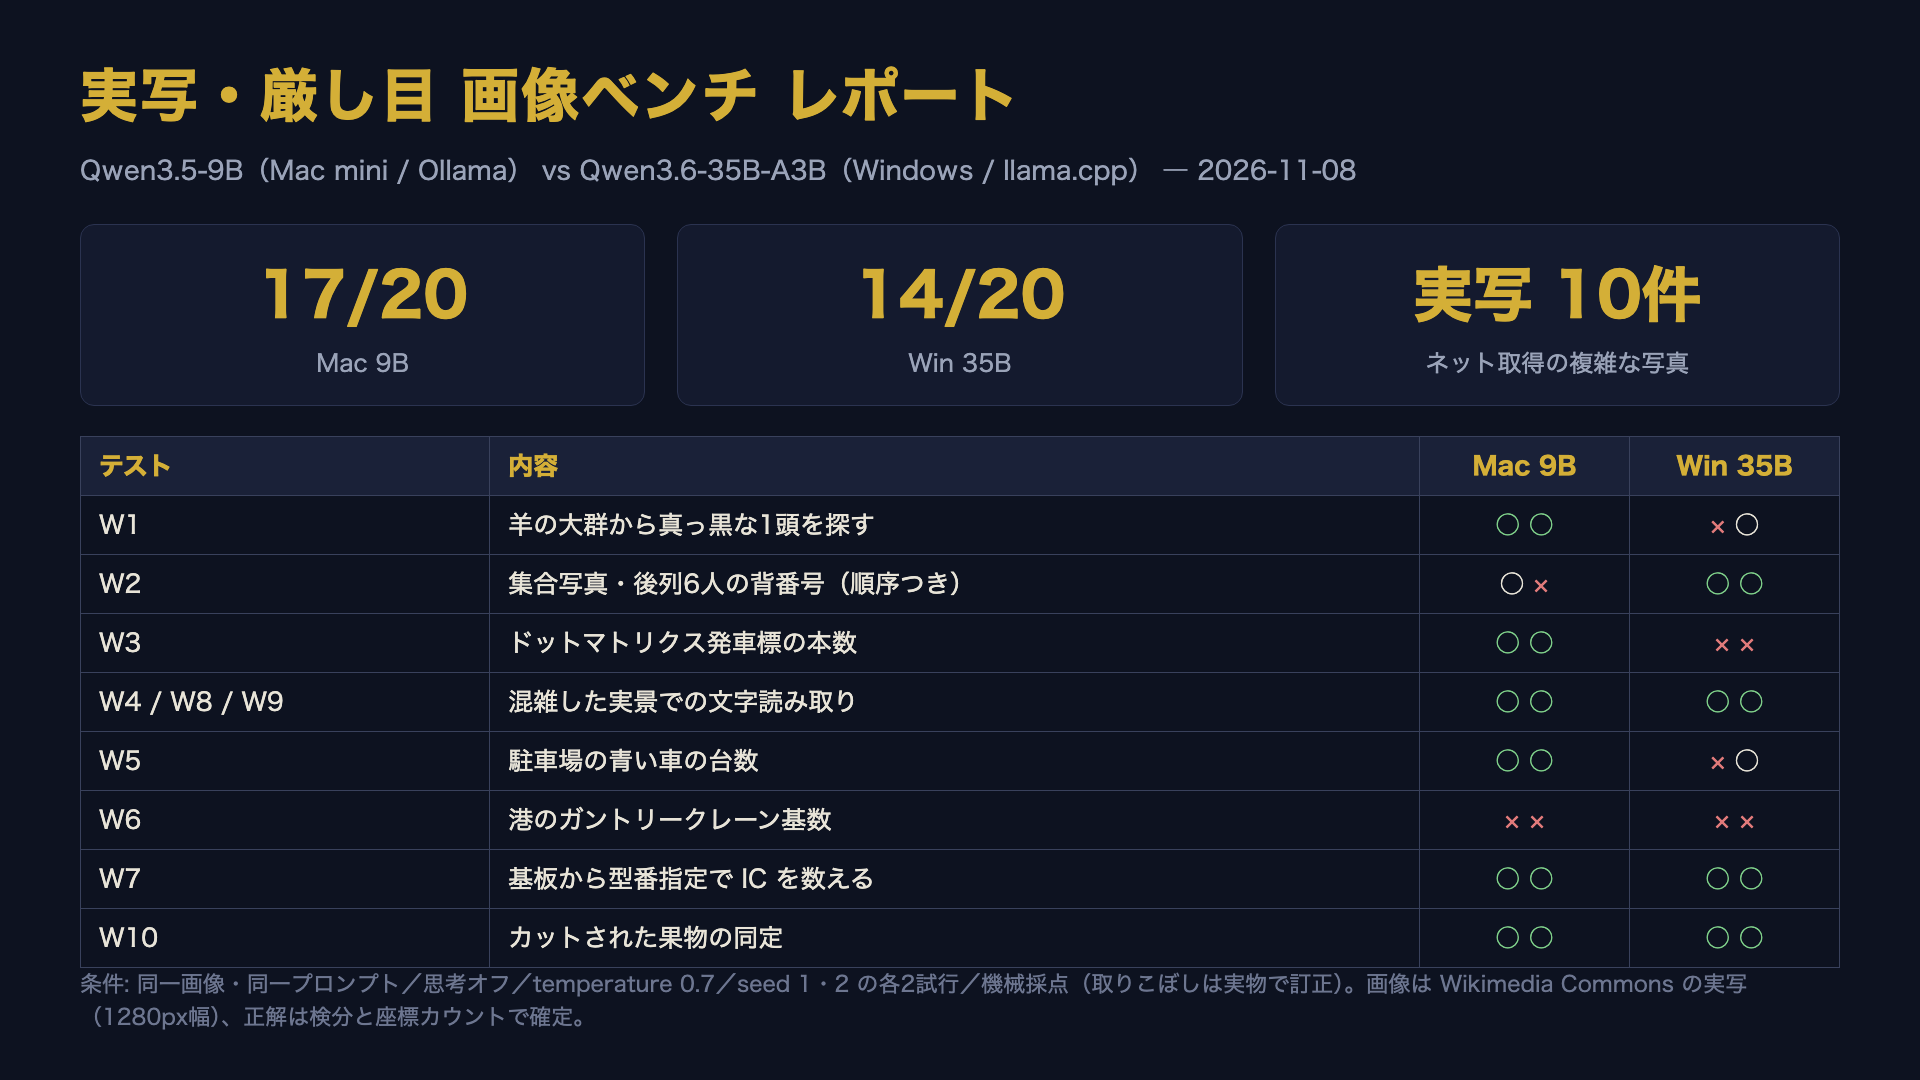
実写・厳し目ベンチ W1〜W10
Mac 17 ― Win 14
実写では逆転。両機の壁は「密な数え上げ」、読み取りと探索は鉄板。
→ 「実写ベンチ」タブ
ずんだ台本ベンチ
一発生成 約70% → 方式改善で 85点 まで。「モデルの限界」の大半は方式の限界だった。
→ 「台本・調査」タブ
Strata 調査
結論: 移行メリットなし(llama.cpp 継続)。RTX 3080 10GB は公式最低ライン未満、現行モデル群は非対応。
→ 「台本・調査」タブ
最終実測(ルーター経由)
| ティア | モデル | 速度 |
|---|---|---|
| A | Qwen3.5-9B UD-Q4_K_XL | 77.27 tok/s |
| B | Qwen3.6-35B-A3B UD-IQ4_XS | 21.54 tok/s |
| C | Qwen3.5-4B Q4_K_M | 108.56 tok/s |
チューニング: Tier A は MTP ドラフトが逆効果(27.51 → 76.16 で無効化)。Tier B は --cpu-moe で 4.39 → 22.41、VRAM は約5.9GB のみ使用。
使用メモリ: Mac 9B は常駐 約10.2GB(ユニファイド)。Win 35B は生成中ピークで VRAM 約6.7GB+RAM 約5.9GB。ベンチ全56+40試行の生成時間は各機 1〜3分程度で、大半は段取りと採点の時間。
ずんだ台本ベンチ(Win 35B・テンプレ v0.4)
| 版 | 方式 | 評価 |
|---|---|---|
| 初稿 | 一発生成(約100発話) | 約70% |
| ループ v1 | ダメ出しのみ ×4周・全文再生成 | 77点 |
| ベンチ v2 | 機械計測フィードバック+章別編集・temp 0.25 | 83点 |
| 語尾徹底パス | 「ですわ」系を全廃+「のだ」締めを徹底 | 約85点 |
Strata 調査の結論
移行メリットなし。対象は Qwen3.8-Flash-Next(125B)単一用途で対応3系統のみ。RTX 3080 10GB は公式最低 12GB 未満、9B / 4B / bge-m3 / ルーターは非対応。12GB 級なら Flash-Next の併設試験のみ価値あり(同条件機で IQ3 約40〜50 tok/s の未検証報告)。
モデル能力ベンチ(公表値)
| モデル | MMLU-Pro | GPQA | SWE-V | AA |
|---|---|---|---|---|
| Flash-Next 125B | 88.5 | 91.7 | 78.8 | 56 |
| 35B-A3B | 85.2 | 86.0 | 73.4 | — |
| 9B | 82.5 | 81.7 | — | 37 |
| 4B | 79.1 | 76.2 | — | — |
公式カード値(思考最大)と独立測定の混在。125B は 35B の +3〜6点。